El aprendizaje por refuerzo (RL) es excelente para aprender qué hacer cuando la señal de recompensa es clara y el entorno es indulgente. Pero muchos escenarios del mundo real no son así. Son complejos, de alto riesgo y llenos de decisiones "casi correctas". Ahí es donde los conjuntos de datos de razonamiento validados por expertos se convierten en un factor multiplicador: enseñan a los modelos el porqué de una acción, no solo el resultado.
El cuello de botella oculto en el rendimiento del aprendizaje directo: señales de razonamiento débiles
Los agentes de RL pueden lucir impresionantes durante el entrenamiento y aun así fallar en la implementación. Una razón común es que el modelo aprende atajos: patrones que generan recompensas en escenarios familiares, pero colapsan cuando las condiciones cambian.
Aquí hay una mini historia que reconocerás si has enviado sistemas RL:
Un equipo de robótica de almacén entrena a un robot para recoger y colocar artículos. En la simulación, las tasas de éxito aumentan rápidamente. Pero en entornos reales, el robot empieza a aprovecharse del sistema, tomando trayectorias arriesgadas que funcionan en el simulador pero provocan colisiones cerca de superficies reflectantes. La función de recompensa no era errónea. El razonamiento que aprendió el modelo era incompleto.
Cuando sus datos solo capturan resultados (“éxito/fracaso” o una recompensa escalar), se pierde la lógica de decisión intermedia que los humanos usan instintivamente: restricciones, controles de seguridad y ordenamiento de pasos.
Qué incluyen realmente los “datos de razonamiento examinados por expertos”
En un nivel práctico, los datos de razonamiento examinados por expertos son un conjunto seleccionado de ejemplos en los que los especialistas del dominio validan la ruta de decisión, no solo el resultado final.
Rastros del razonamiento: el punto medio que falta
Un rastro de razonamiento es la ruta paso a paso desde la observación → decisión → acción. Dependiendo de su caso de uso, podría ser así:
- Identificación de señales relevantes (“desviación del sensor detectada; confianza reducida”)
- aplicando las reglas del dominio (“ceda el paso antes de entrar; priorice a los peatones”)
- Seleccionar acciones con restricciones (“elegir la ruta B para evitar el punto ciego”)
Qué significa “vetado” (en términos sencillos)
“Verificado” generalmente incluye:
- directrices redactadas o revisadas por expertos
- Rúbricas de etiquetado consistentes (para que dos expertos resuelvan el mismo caso de manera similar)
- controles sistemáticos para detectar contradicciones y pasos omitidos
- Un registro de auditoría de los cambios a medida que evolucionan las directrices
Esto es importante porque pequeños errores lógicos pueden tener consecuencias, especialmente cuando más adelante se entrenan modelos de recompensa o se utilizan ciclos de retroalimentación humana.
Cómo los conjuntos de datos de razonamiento mejoran el rendimiento del modelo de aprendizaje de refuerzo
Los beneficios no son místicos. Son mecánicos.
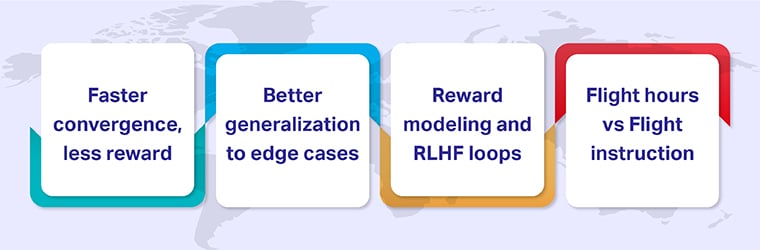
Convergencia más rápida, menos piratería de recompensas
Los rastros de razonamiento reducen el espacio de búsqueda. En lugar de explorar a ciegas, el agente recibe señales estructuradas sobre qué pasos intermedios son válidos. Esto suele significar menos iteraciones de entrenamiento desperdiciadas en callejones sin salida y menos explotaciones ingeniosas de la función de recompensa.
La investigación sobre el aprendizaje directo y el modelado de recompensas destaca repetidamente la sensibilidad del entrenamiento a datos de preferencia/retroalimentación ruidosos o de baja calidad (Fuente: Asociación de Lingüística Computacional, 2024). Esta sensibilidad no desaparece en el aprendizaje directo, sino que se amplifica.
Mejor generalización a casos extremos
El razonamiento experto codifica restricciones y principios transferibles: límites de seguridad, normas de cumplimiento y lógica causal. Cuando el entorno cambia, esos principios se mantienen, aunque los píxeles, el texto o las transiciones de estado exactos no varíen.
Modelado de recompensas más estable y bucles RLHF
Si utilizas un postentrenamiento estilo RLHF, los datos de razonamiento te ayudan a crear mejores modelos de recompensa, ya que el modelo de recompensa puede aprender a puntuar no solo las "buenas respuestas", sino también las "buenas rutas de decisión". Esto se traduce en actualizaciones más consistentes durante la optimización y menos regresiones al escalar el entrenamiento.
Si está creando o ampliando sistemas RLHF, las soluciones RLHF de Shaip están diseñadas en torno a flujos de trabajo dirigidos por expertos y controles de calidad que garantizan la coherencia de los datos de alineación.
Una analogía: horas de vuelo vs. instrucción de vuelo
Piensa en el entrenamiento de aprendizaje por refuerzo como en el entrenamiento de pilotos. Puedes pasar incontables horas en un simulador, pero si refuerzas los malos hábitos, los consolidarás. Un instructor no se limita a decir "aprobado/suspenso". Corrige tu razonamiento en pleno vuelo: el orden de escaneo, el momento de la decisión y la gestión del riesgo. Los conjuntos de datos de razonamiento validados por expertos desempeñan ese papel de "instructor" en el aprendizaje por refuerzo, enseñando al modelo a analizar la tarea, no solo a determinar si la completó con éxito.
Tabla comparativa: modelos de evaluación interna, de colaboración colectiva y subcontratación
La mayoría de los equipos terminan con un híbrido, pero ayuda ser explícito acerca de las compensaciones.
Para necesidades de etiquetado más amplias que se integran en los flujos de trabajo de aprendizaje por refuerzo (RL) y aprendizaje por refuerzo basado en modelos (RLHF), los servicios de anotación de datos de Shaip pueden brindar soporte para todo, desde el diseño de directrices hasta el control de calidad en varias etapas, especialmente cuando se necesita una calidad repetible a gran escala.
Un manual práctico de control de calidad para conjuntos de datos de razonamiento examinados por expertos
A continuación se presenta un manual que refleja lo que los equipos de alto rendimiento ponen en práctica.
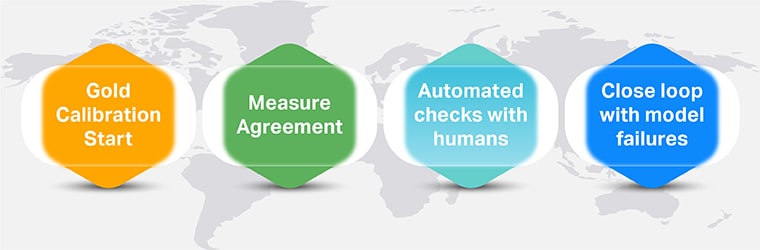
1. Comience con el “oro” y la calibración
Crea un conjunto de ejemplos canónicos de referencia (incluyendo casos extremos complejos). Úsalo para calibrar a los anotadores y coordinar a los expertos sobre cómo se ve el "buen razonamiento".
2. Medir el acuerdo y luego resolver los desacuerdos correctamente
Utilice el consenso entre anotadores cuando sea apropiado (y evite forzar un acuerdo en casos inherentemente ambiguos). La clave es el arbitraje : los desacuerdos deben generar mejores directrices, no solo una etiqueta al azar.
3. Agregue controles automatizados, pero mantenga a los humanos a cargo
Automatiza lo que es barato de verificar:
- consistencia del formato (número de pasos, validez del esquema)
- violaciones de reglas (restricciones faltantes, acciones prohibidas)
- detección de contradicciones (el paso dice “A”, luego implica “no A”)
Luego, envía los artículos marcados a revisión experta. Aquí es donde el control de calidad híbrido entre humanos e IA da sus frutos: las máquinas detectan los errores obvios y los expertos corrigen los errores sutiles.
4. Cerrar el círculo con fallas del modelo
Trate los fallos de implementación como retroalimentación del conjunto de datos. Cuando el modelo falla, pregunte:
- ¿Faltaba una restricción en el rastro del razonamiento?
- ¿Las directrices no especificaron adecuadamente el caso extremo?
- ¿Nos adaptamos demasiado a la lógica del “camino feliz”?
Este ciclo convierte tu conjunto de datos en un activo vivo, no en un producto que se entrega una sola vez. Para los equipos que crean flujos de datos de principio a fin (recopilación → control de calidad → entrega), los servicios de datos de entrenamiento de IA de Shaip pueden ayudar a operacionalizar esto de forma continua.
Marco de decisión: cómo elegir la estrategia de investigación adecuada
Utilice estas seis preguntas para elegir la combinación adecuada de servicios internos, colectivos y administrados: