En la IA física, el modelo rara vez es el cuello de botella, sino los datos. Una política de robot que funciona a la perfección en una demostración y luego falla en un almacén real casi siempre se debe a los datos que no ha visto, no a la arquitectura. Esto plantea una cuestión presupuestaria para cada equipo de robótica: al decidir entre datos sintéticos y datos reales para la robótica, ¿cuál debería comprar? Ambos tienen ventajas y costes reales, y la respuesta correcta depende de la etapa en la que se encuentre su proyecto.
Puntos Clave
- Los datos sintéticos son económicos, escalables y seguros para generar casos límite a gran escala.
- Los datos del mundo real capturan el ruido del sensor y la variabilidad de cola larga que la simulación no detecta.
- La brecha entre la simulación y la realidad es la principal razón por la que los modelos exclusivamente sintéticos fracasan en su implementación.
- El coste de la recopilación de datos del mundo real aumenta en función de las horas de captura; los datos sintéticos, una vez construidos, aumentan de forma económica.
- Los datos sintéticos cubren las lagunas; los datos del mundo real sirven de base para la formación. El enfoque híbrido triunfará en 2026.
- Compra datos sintéticos con anticipación, compra datos del mundo real antes de realizar ajustes y despliegues.
¿Qué son los datos sintéticos para la robótica?

Los datos sintéticos para robótica son datos de entrenamiento generados artificialmente mediante simulación, en lugar de ser capturados de robots físicos en el mundo real. Un motor de física o modelo del mundo renderiza escenas, movimiento y lecturas de sensores, y etiqueta automáticamente cada fotograma con datos precisos.
Dado que el simulador conoce la posición, la masa y el movimiento exactos de cada objeto, genera etiquetas impecables a una velocidad inalcanzable para cualquier proceso manual. Los datos sintéticos abarcan cuatro tipos principales: visión (imágenes segmentadas, iluminación variada), 3D y profundidad (nubes de puntos, mapas de navegación), movimiento (trayectorias, ángulos articulares, velocidad) e interacción (agarre, contacto, colisión). La aleatorización del dominio —que consiste en variar deliberadamente los colores, las texturas y la iluminación más allá de los rangos realistas— obliga a los modelos a centrarse en las características relevantes para la tarea.
Aleatorización de dominio: una técnica que modifica la apariencia de la simulación más allá de los límites realistas para que los modelos se generalicen a condiciones reales que nunca se mostraron explícitamente.
[Lea también: El conjunto de datos de IA física ]
¿Qué son los datos del mundo real para la robótica?
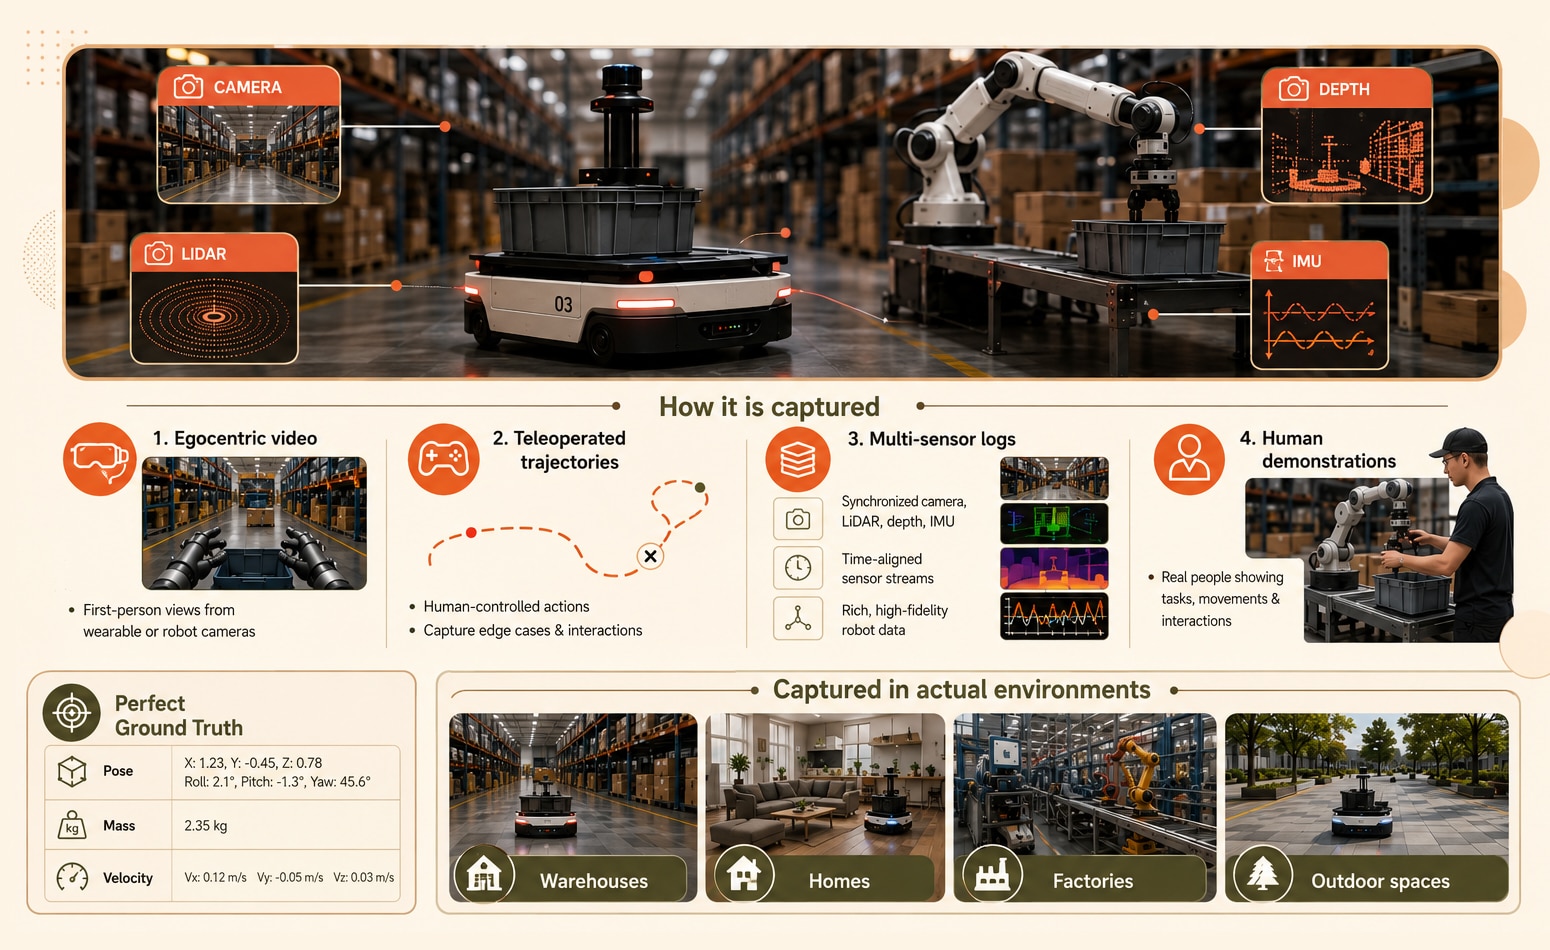
Los datos reales para robótica son datos de entrenamiento obtenidos mediante sensores físicos, teleoperación o demostraciones humanas en entornos reales. Estos datos reflejan el ruido real, las variaciones de iluminación y la variabilidad impredecible a la que se enfrenta un robot en el momento en que sale del laboratorio.
Estos son los datos que fundamentan un modelo en la realidad. Incluyen vídeo egocéntrico (en primera persona), trayectorias de manipulación teleoperada, registros multisensor que combinan flujos de cámara, LiDAR, profundidad e IMU, y grabaciones de demostraciones humanas. La recopilación de datos reales de Shaip abarca vídeo egocéntrico, teleoperación y captura de manipulación en diversos entornos globales, precisamente los escenarios de alta variabilidad que la simulación tiene dificultades para reproducir.
Datos egocéntricos: Grabaciones de vídeo y sensores en primera persona, capturadas desde una cámara montada en la cabeza, el pecho o la muñeca, que reflejan lo que ve un robot durante una tarea.
Datos sintéticos frente a datos del mundo real: ¿cómo se comparan?
Los datos sintéticos y los datos reales resuelven problemas opuestos. Los datos sintéticos ofrecen ventajas en cuanto a coste, escalabilidad y cobertura de casos extremos; los datos reales, en cambio, destacan por su realismo, la fidelidad de los sensores y su fiabilidad para la implementación. La siguiente tabla muestra las ventajas y desventajas que los compradores tienen más en cuenta.
¿Qué es la brecha entre la simulación y la realidad, y por qué es importante?
La brecha entre simulación y realidad es la disminución del rendimiento que se produce cuando un modelo entrenado en simulación se enfrenta a condiciones del mundo real que su entrenamiento nunca reprodujo. Es la principal razón por la que los modelos robóticos exclusivamente sintéticos fallan en la producción.
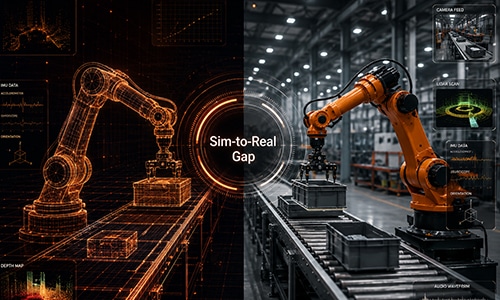
Imagínelo como un piloto que solo ha volado en un simulador. Puede dominar cualquier escenario programado, pero la primera vez que se enfrenta a turbulencias reales —de esas que el simulador suavizó— su entrenamiento demuestra sus limitaciones. Los robots se comportan de la misma manera: un sistema que domina un almacén virtual impecable puede bloquearse cuando aparece una carretilla elevadora real desde un ángulo no modelado, o cuando la luz del sol inunda un sensor de una forma que el motor de renderizado nunca captó.
Las simulaciones se basan en supuestos físicos simplificados y rara vez modelan artefactos de sensores, casos extremos de materiales o condiciones realmente adversas. Los datos del mundo real subsanan esta deficiencia al anclar el modelo en la amplia variabilidad que solo la captura física puede contener.
[Lea también: Qué necesitan los modelos VLA de los datos de entrenamiento ]
¿Cómo se compara el coste de los datos sintéticos con el de los datos reales?
La diferencia de costes entre los datos sintéticos y los del mundo real es estructural, no se trata solo de una cuestión de precios. Los datos sintéticos conllevan un alto coste inicial para la creación del sistema de generación, tras lo cual el coste marginal de cada fotograma adicional se reduce prácticamente al coste computacional. Los datos del mundo real funcionan al revés: el coste aumenta de forma aproximadamente lineal con cada hora de captura física y cada secuencia etiquetada.
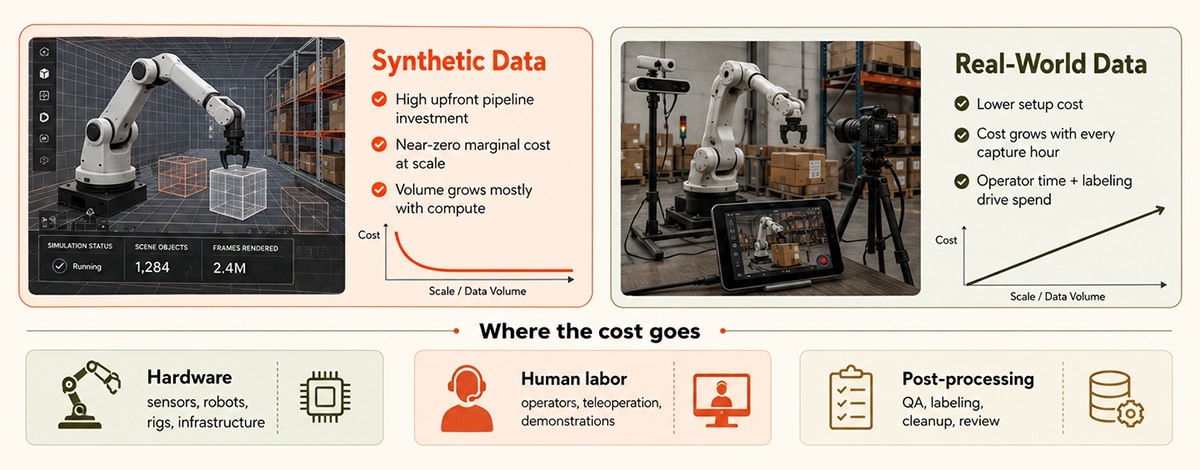
El coste de los datos de entrenamiento de robots se divide en tres categorías: hardware, mano de obra humana y posprocesamiento, y el equilibrio entre ellas depende del enfoque adoptado:
- Sintéticos: alta inversión inicial en infraestructura, coste marginal casi nulo para aumentar el volumen de producción.
- En la práctica: la configuración inicial es menor, pero el coste aumenta con cada hora de captura, el tiempo del operador y el etiquetado.
- Híbrido: el sistema sintético absorbe la carga de alto volumen; el sistema de gasto en condiciones reales se concentra donde el realismo es más importante.
Esta asimetría es clave en la decisión de compra. Los datos sintéticos permiten escalar a bajo costo una vez que la infraestructura está establecida, mientras que los datos reales concentran el presupuesto a medida que se acerca la implementación. Sin embargo, un menor costo no equivale a un menor riesgo, y ahí radica la complejidad de la decisión.
¿Cuál deberías comprar para tu proyecto de IA física?
Adquiera datos sintéticos cuando necesite escalabilidad, seguridad y velocidad en las primeras etapas del desarrollo; adquiera datos reales cuando necesite reducir la brecha entre la simulación y la realidad antes del ajuste fino y la implementación. La etapa de su proyecto, no la ideología, debe ser el factor determinante para esta decisión.
Imaginemos una empresa de logística de tamaño mediano que construye un robot móvil autónomo para un nuevo centro de distribución. Al principio, no tienen hardware físico, así que se basan casi por completo en datos sintéticos: generan miles de diseños virtuales de pasillos, derrames y situaciones de riesgo con montacargas para entrenar la percepción y la navegación de forma segura. Cuando llegan las primeras unidades físicas, la situación cambia: invierten en la captura de datos reales de sus instalaciones para ajustar el comportamiento frente a las peculiaridades que ningún simulador predijo: suelos reflectantes, el resplandor del muelle de carga a las 4 de la tarde, un palé envuelto en una película inusual. Los datos sintéticos los pusieron en marcha; los datos reales los hicieron operativos.
Un marco de decisión práctico:
- Antes de la fabricación del hardware o en las primeras etapas de I+D, se prioriza el uso de materiales sintéticos para el preentrenamiento y las pruebas de estrés.
- Escenarios raros, peligrosos o que comprometen la privacidad → sintéticos para generarlos de forma segura y en grandes cantidades.
- Ajuste fino para un entorno específico → datos reales de ese entorno.
- Validación y certificación de seguridad → datos del mundo real, siempre.
Por qué una estrategia híbrida de datos robóticos triunfará en 2026
Una estrategia híbrida de datos para robótica utiliza datos sintéticos para cubrir deficiencias específicas, al tiempo que basa el entrenamiento en datos reales que fundamentan el modelo en una variabilidad genuina. Este es el enfoque que adoptan los equipos de producción una vez que los pilotos que utilizan únicamente datos sintéticos se topan con las limitaciones de la simulación frente a la realidad.
El razonamiento es sencillo. Los datos sintéticos proporcionan el volumen y los casos extremos; los datos del mundo real aportan el realismo y la confianza. Shaip basa los programas de IA física en demostraciones del mundo real y datos egocéntricos, al tiempo que admite la generación sintética para la cola larga, de modo que los equipos consiguen escalabilidad sin sacrificar la estabilidad que mantiene a un robot seguro en el suelo. Para los equipos que necesitan conjuntos de datos listos rápidamente, las licencias de datos preconfigurados y seleccionados pueden acortar aún más el proceso.
¿Cómo se evalúa a un socio de datos para robótica?
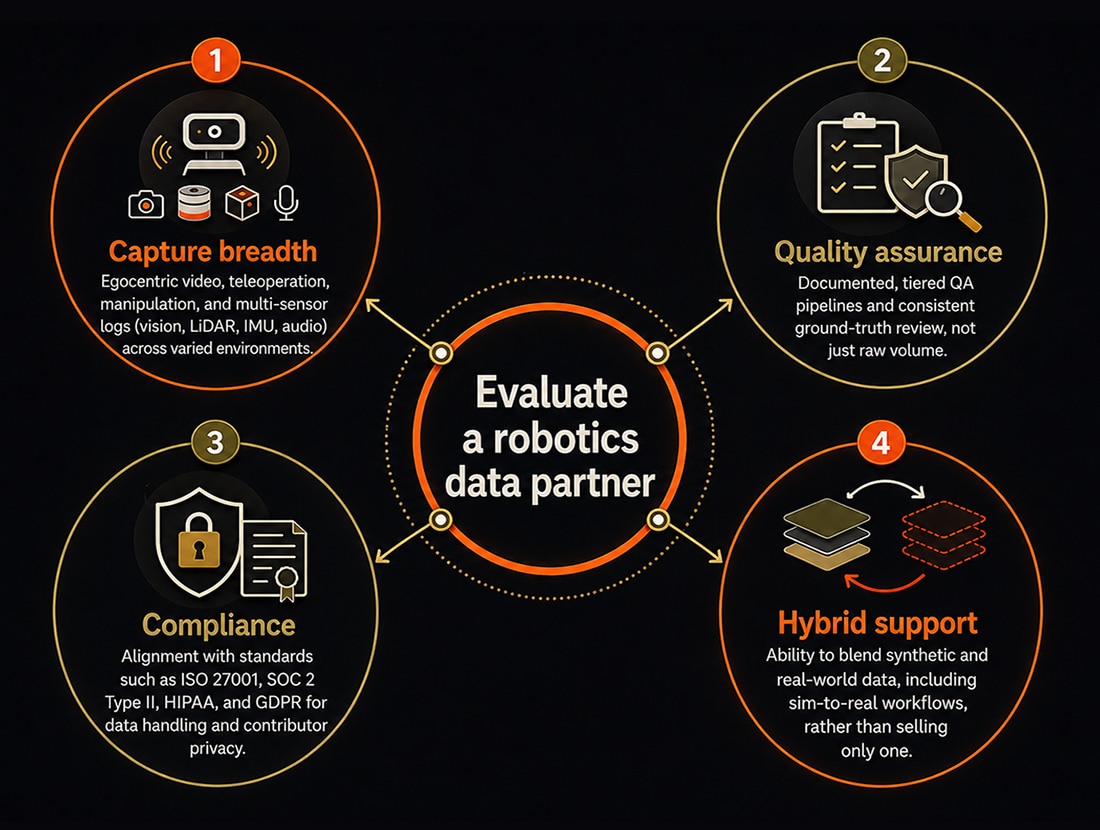
Evalúe a un socio de datos robóticos en función de su capacidad de captura en entornos reales, cobertura de la infraestructura, garantía de calidad y cumplimiento normativo, no solo del precio. Dado que la recopilación de datos en entornos reales involucra entornos sensibles y colaboradores humanos, la seguridad y la gobernanza son tan importantes como la precisión del etiquetado.
- Captura una amplia gama de datos: vídeo egocéntrico, teleoperación, manipulación y registros multisensor (visión, LiDAR, IMU, audio) en diversos entornos.
- Garantía de calidad: procesos de control de calidad documentados y escalonados, y una revisión constante de la información de referencia, no solo del volumen bruto.
- Cumplimiento: alineación con estándares como ISO 27001, SOC 2 Tipo II, HIPAA y GDPR para el manejo de datos y la privacidad de los contribuyentes.
- Soporte híbrido: la capacidad de combinar datos sintéticos y del mundo real, incluidos los flujos de trabajo de simulación a la realidad, en lugar de vender solo uno de ellos.
En todos estos criterios, los servicios de datos de IA física de Shaip están diseñados para equipos de robótica e IA integrada como socio integral, abarcando la recopilación multimodal, la anotación compleja de VLA y acciones, la generación de datos sintéticos, RLHF y la evaluación en un solo proyecto. Shaip captura datos de entornos reales donde operan los modelos (cocinas, almacenes, fábricas, calles e instalaciones sanitarias) a través de una red global de recolectores gestionada, en lugar de la colaboración abierta, con controles que cumplen con las normas ISO 27001, SOC 2 Tipo II, HIPAA y GDPR.
Esa experiencia se manifiesta a gran escala. En un programa de robótica humanoide, Shaip construyó toda la infraestructura de operaciones de datos —configuración de escenas con códigos QR, seguimiento con cinco sensores, ensayos moderados y control de calidad para modelos listos— para generar 10 000 horas de datos de movimiento de realidad virtual egocéntricos con aproximadamente 4,000 participantes y 100 tareas en tan solo 30 días. Lea el estudio de caso completo para ver cómo se estructuró el programa, desde la configuración hasta la entrega lista para su implementación.