Todos los equipos de visión artificial acaban topándose con el mismo obstáculo: los datos que más necesitas son los que no puedes obtener. El incidente que casi termina en accidente. El defecto que aparece una vez cada diez mil unidades. El escenario demasiado peligroso, demasiado raro o demasiado privado para ser captado por una cámara.
Aquí es donde los datos sintéticos demuestran su valía: imágenes y escenas generadas por ordenador que cubren las carencias de la recopilación de datos reales. Sin embargo, los datos sintéticos son una herramienta, no un atajo, y los equipos que los utilizan sin reparo suelen descubrir sus fallos en la producción. A continuación, analizamos con objetividad cuándo son útiles, cuándo resultan contraproducentes y cómo utilizarlos correctamente.
Utilice datos sintéticos cuando los necesite.
Existen cinco situaciones que justifican sistemáticamente el uso de datos sintéticos.
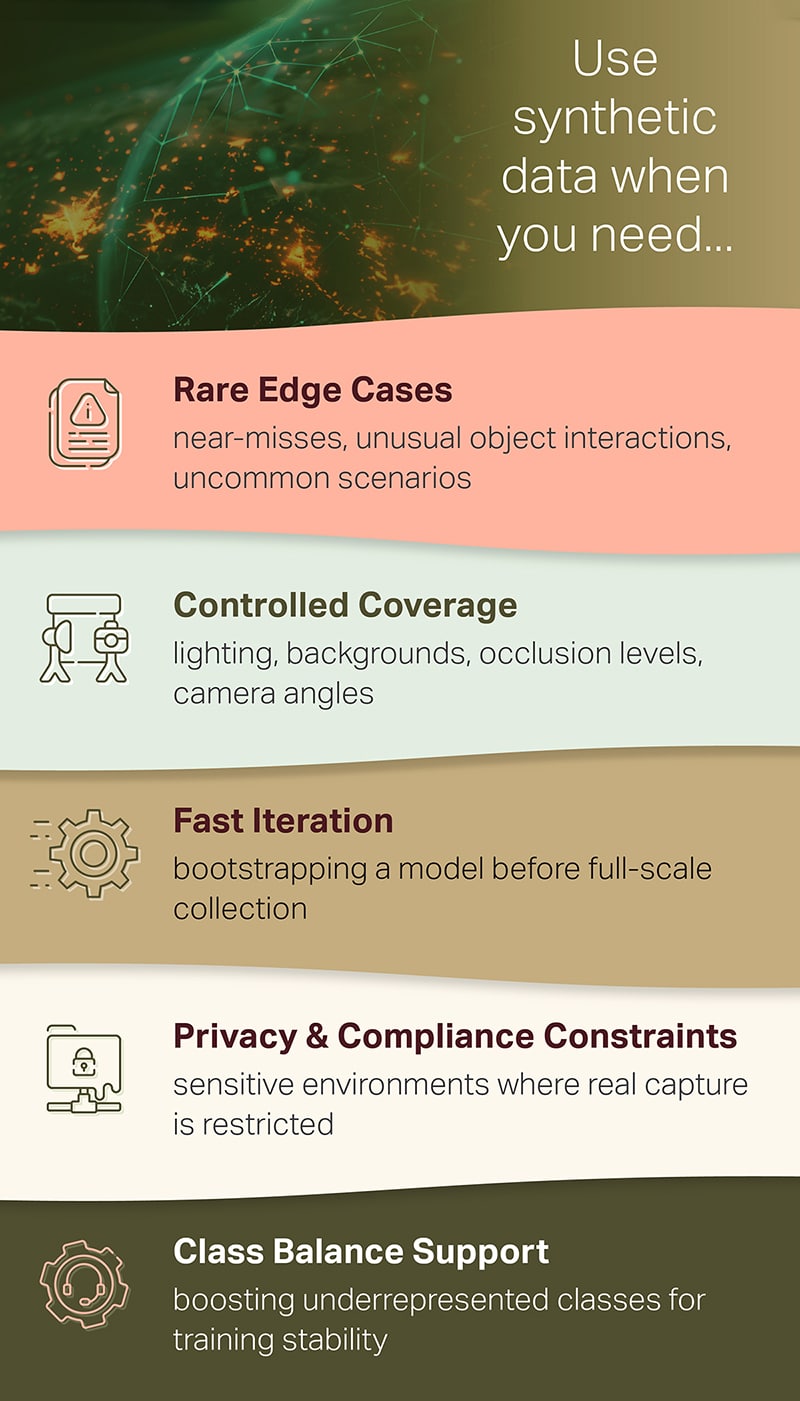
Casos límite excepcionales. Situaciones de riesgo extremo, interacciones inusuales entre objetos, escenarios poco comunes: los eventos más importantes para la seguridad y la robustez son precisamente aquellos que apenas se encuentran en tu conjunto de datos real. La generación sintética te permite crear mil variaciones de un evento que solo has visto dos veces.
Cobertura controlada. La recopilación de imágenes reales te proporciona la iluminación, los fondos, los niveles de oclusión y los ángulos de cámara que capturaste por casualidad. Los flujos de trabajo sintéticos te permiten variar sistemáticamente esas variables (cada ángulo del sol, cada oclusión parcial, cada altura de la lente), de modo que la cobertura se convierte en una decisión de diseño en lugar de una casualidad.
Iteración rápida. Al inicializar un modelo antes de la recopilación a gran escala, los datos sintéticos permiten entrenar la primera versión en días, en lugar de meses. Así, se descubren las dificultades del modelo antes de invertir el presupuesto de recopilación.
Restricciones de privacidad y cumplimiento normativo. En entornos sensibles donde la captura real está restringida (hospitales, escuelas, lugares de trabajo con normas de privacidad estrictas), las escenas sintéticas proporcionan una señal de entrenamiento sin ningún rostro o identidad real en el proceso.
Soporte para el equilibrio de clases. Cuando algunas clases están muy poco representadas, los modelos se entrenan de forma inestable e ignoran a la minoría. Los ejemplos sintéticos pueden potenciar la representación de las clases menos representadas para restablecer la estabilidad del entrenamiento.
Advertencias: Los sintéticos pueden ser contraproducentes si
Ahora viene la parte honesta. Los datos sintéticos fallan de maneras predecibles, y cada una de ellas se puede evitar si uno sabe dónde buscar.
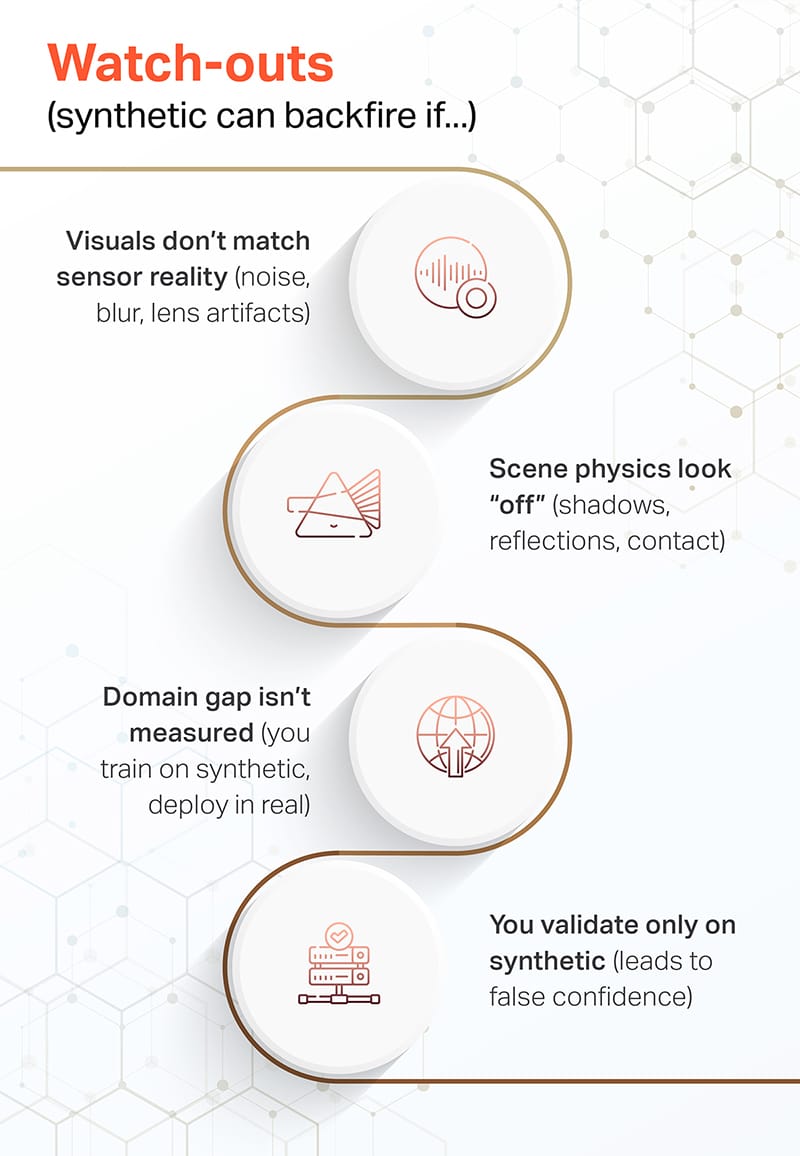
Las imágenes no coinciden con la realidad del sensor. La cámara de despliegue presenta ruido, desenfoque y artefactos de lente. Si las imágenes sintéticas son más nítidas que cualquier imagen que produzca el sensor, el modelo aprende un mundo que no existe.
La física de la escena parece "desproporcionada". Sombras que caen en la dirección equivocada, reflejos que no se comportan como deberían, objetos que no llegan a tocar las superficies. Los humanos no le dan importancia a estos detalles; los modelos los aceptan como si fueran la verdad absoluta.
La brecha de conocimiento del dominio no se mide. El error clásico: entrenar con datos sintéticos, implementar en entornos reales y nunca cuantificar la diferencia entre ambos. Si no se mide la brecha de conocimiento del dominio, se está adivinando.
La validación se realiza únicamente con datos sintéticos. Este es el método más peligroso, ya que genera una falsa sensación de seguridad: un modelo que obtiene excelentes resultados en conjuntos de prueba sintéticos, pero que falla estrepitosamente con datos reales. La validación sintética indica que el modelo aprendió del simulador, no del mundo real.
El enfoque de mejores prácticas
Los equipos que tienen éxito con datos sintéticos siguen el mismo ciclo de cinco pasos.
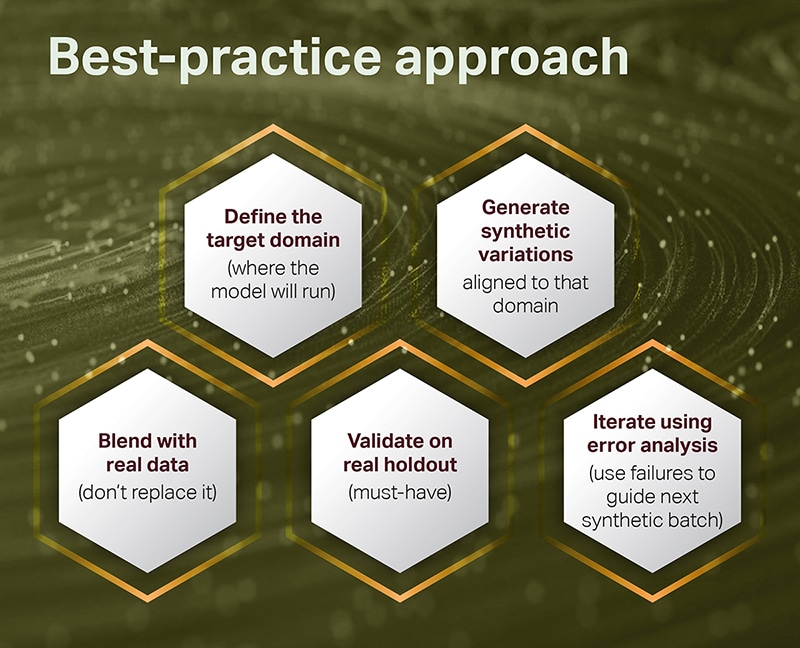
Primero, defina el dominio objetivo : las condiciones reales en las que se ejecutará el modelo, incluyendo el sensor, el entorno y la iluminación. Segundo, genere variaciones sintéticas alineadas con ese dominio , no renderizaciones genéricas. Tercero, combine con datos reales : los datos sintéticos complementan la captura real, no la reemplazan. Cuarto, valide con un conjunto de prueba real . Esto es fundamental: su referencia debe consistir en datos reales que el modelo nunca haya visto. Y quinto, itere utilizando el análisis de errores : deje que los fallos del modelo en el mundo real guíen el contenido del siguiente lote sintético.
Definir → generar → mezclar → validar en datos reales → iterar. El bucle es más importante que cualquier paso individual.
¿Deberías usar datos sintéticos? Un marco de decisión rápido.
Cuatro preguntas bastan para zanjar la mayoría de los debates.
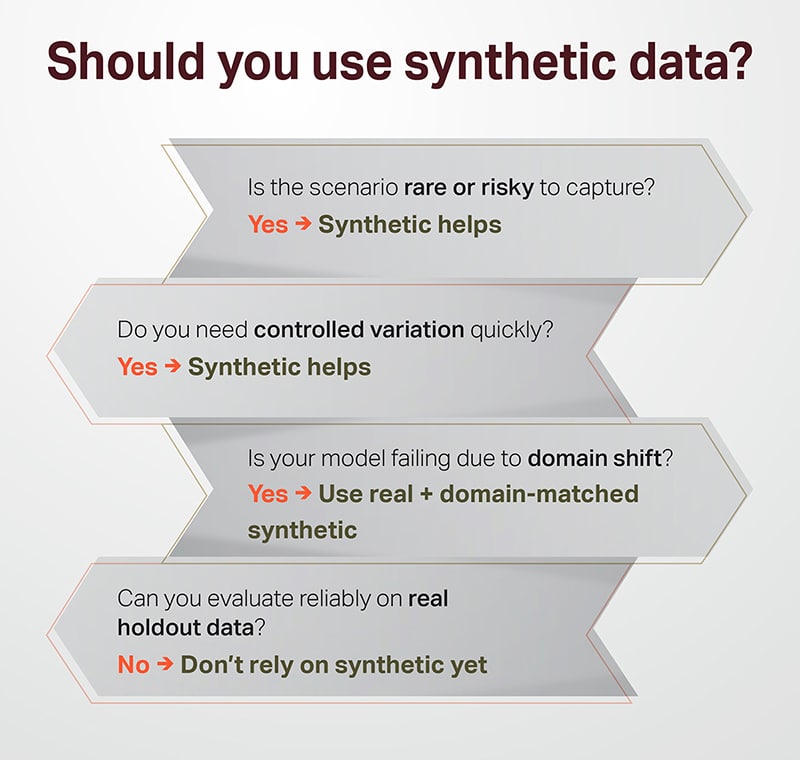
¿Es raro o arriesgado capturar este escenario ? Si es así, los datos sintéticos son útiles. ¿Necesitas variación controlada rápidamente ? Si es así, los datos sintéticos son útiles. ¿Tu modelo falla debido a un cambio de dominio ? Si es así, usa datos reales junto con datos sintéticos que coincidan con el dominio; los datos sintéticos por sí solos no cerrarán una brecha que no pueden ver. Y finalmente: ¿puedes evaluar de forma fiable con datos de validación reales ? Si no, no confíes aún en los datos sintéticos; primero crea tu conjunto de evaluación real, porque sin él no puedes saber si los datos sintéticos están ayudando o perjudicando silenciosamente.
Lo más importante es...
Los datos sintéticos son una de las herramientas más poderosas en el campo de la visión artificial, ya que permiten analizar casos excepcionales, garantizar la cobertura, aumentar la velocidad, proteger la privacidad y lograr un equilibrio óptimo. Sin embargo, también son una de las más fáciles de usar incorrectamente, dado que sus fallos se ocultan tras métricas aparentemente favorables hasta el día de la implementación.
Los equipos que lo hacen bien lo tratan como una disciplina de ingeniería: datos reales como base, datos sintéticos como refuerzo específico y validación en el mundo real como criterio innegociable. Ese es el enfoque que Shaip adopta con los equipos de visión artificial: planificar la combinación adecuada de datos reales y sintéticos, con control de calidad medible y validación centrada en la implementación, de modo que el modelo que funciona en el entrenamiento sea el mismo que funciona en el campo.