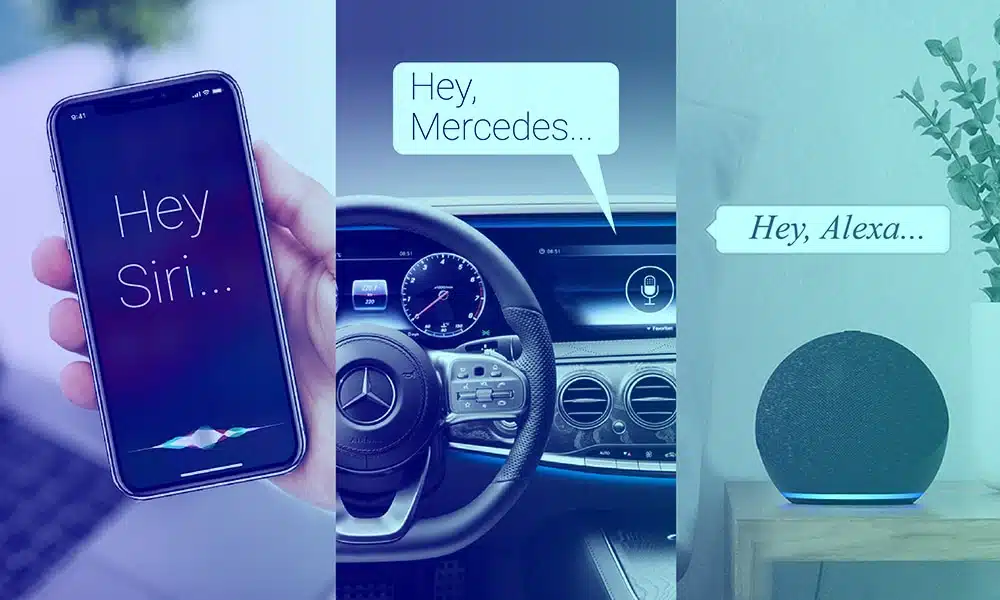
¿Alguna vez te has preguntado cómo se despiertan los chatbots y los asistentes virtuales cuando dices "Oye, Siri" o "Alexa"? Es debido a la recopilación de expresiones de texto o las palabras desencadenantes integradas en el software que activa el sistema tan pronto como escucha la palabra de activación programada.
Sin embargo, el proceso general de creación de sonidos y datos de pronunciación no es tan simple. Es un proceso que debe llevarse a cabo con la técnica adecuada para obtener los resultados deseados. Por lo tanto, este blog compartirá la ruta para crear buenos enunciados/palabras desencadenantes que funcionen a la perfección con su IA conversacional.
¿Qué es un “enunciado” en IA?
En la IA conversacional (chatbots, asistentes de voz), un enunciado es una breve entrada del usuario: las palabras exactas que una persona dice o escribe. Los modelos utilizan los enunciados para determinar la intención del usuario (objetivo) y cualquier entidad (detalles como fechas, nombres de productos, cantidades).
Ejemplos sencillos
bot de comercio electrónico
Expresión: “ Rastrear mi pedido 123-456 .”
- Intención: Seguimiento de pedido
- Entidad: order_id = 123-456
Bot de telecomunicaciones
Expresión: “ Actualizar mi plan de datos ”.
- Intención: Plan de cambio
- Entidad: plan_type = datos
Asistente de voz bancario
Expresión (hablada): “¿Cuál es el saldo de mi cuenta corriente hoy? ”
- Intención: CheckBalance
- Entidades: account_type = cheques, fecha = hoy
Por qué su IA conversacional necesita buenos datos de enunciados
Si quieres que tu chatbot o asistente de voz sea útil, no rígido, empieza por mejorar los datos de enunciados. Descubre cómo lo hicimos en este caso práctico de recopilación de enunciados : 22 000 horas en 13 idiomas. Los enunciados son las frases que la gente dice o escribe para realizar tareas («reserva una habitación para mañana», «cambia mi plan», «¿cuál es el estado?»). Estos datos impulsan la clasificación de intenciones, la extracción de entidades y, en definitiva, la experiencia del cliente. Si prefieres escalar esto con un socio, los servicios de datos de IA conversacional de Shaip se encargan de la recopilación, transcripción y anotación de principio a fin. Cuando los enunciados son diversos, representativos y están bien etiquetados, tus modelos aprenden los límites correctos entre las intenciones y manejan con soltura la información del mundo real, incluso la más compleja.
Construyendo su repositorio de enunciados: un flujo de trabajo sencillo
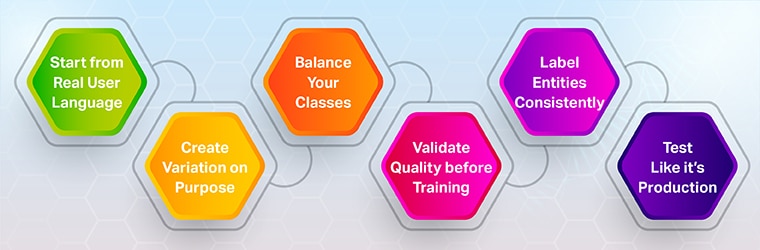
1. Empezar desde el lenguaje real del usuario
Analiza los registros de chat, las consultas de búsqueda, las transcripciones de IVR, las notas de los agentes y los correos electrónicos de los clientes. Agrupa la información según el objetivo del usuario para identificar sus intenciones. (Capturarás expresiones coloquiales y modelos mentales que no se te ocurrirían en una reunión).
2. Crea variación a propósito
Para cada intención, el autor proporciona diversos ejemplos:
- Reformular verbos y sustantivos (“cancelar”, “detener”, “finalizar”; “plan”, “suscripción”).
- Mezclar longitudes y estructuras de oraciones (pregunta, directiva, fragmento).
- Incluya errores tipográficos, abreviaturas, emojis (para chatear) y cambios de código cuando sea relevante.
- Agregue casos negativos que parezcan similares pero que deberían No Mapa para esta intención.
3. Equilibra tus clases
Un entrenamiento extremadamente desequilibrado (por ejemplo, 500 ejemplos para una intención y 10 para otras) perjudica la calidad de la predicción. Mantén el tamaño de las intenciones relativamente uniforme y auméntalas conjuntamente a medida que el tráfico te lo indique.
4. Validar la calidad antes de la capacitación
Bloquear los datos de baja señal con validadores durante la creación/recopilación:
- Detección de idioma: Asegúrese de que los ejemplos estén en el idioma de destino.
- Detector de galimatías: Atrapar cadenas sin sentido.
- Comprobaciones de duplicados/casi duplicados: Mantenga la variedad alta.
- Expresiones regulares/ortografía y gramática: Aplicar reglas de estilo donde sea necesario.
Los validadores inteligentes (como los que utiliza Appen) pueden automatizar grandes partes de este control.
5. Etiquetar las entidades de forma coherente
Defina los tipos de ranuras (fechas, productos, direcciones) e indique a los anotadores cómo marcar los límites . Patrones como Pattern any en LUIS pueden desambiguar intervalos largos y variables (por ejemplo, nombres de documentos) que confunden a los modelos.
6. Prueba como si fuera producción
Envía expresiones reales no vistas a un punto final de predicción o a un bot de prueba, revisa las clasificaciones erróneas y promueve los ejemplos ambiguos al entrenamiento. Crea un ciclo: recopilar → entrenar → revisar → expandir.
Qué significa realmente la “realidad desordenada” (y cómo afrontarla)
Los usuarios reales rara vez hablan con frases perfectas. Espera:
- Fragmentos: “reembolso de gastos de envío”
- Objetivos compuestos: “Cancelar pedido y reordenar en azul”
- Entidades implícitas: “enviar a mi oficina” (debes saber cuál oficina)
- Ambigüedad: “cambiar mi plan” (¿qué plan? ¿cuándo entra en vigor?)
Soluciones prácticas
- Proporcione indicaciones aclaratorias Sólo cuando sea necesario; evite preguntar demasiado.
- Capturar transferencia de contexto (pronombres como “esa orden”, “el último”).
- Usar intenciones de respaldo con recuperación específica: “Puedo ayudarte a cancelar o cambiar planes. ¿Qué te gustaría?”
- Monitorización intención de salud (confusión, colisión) y agregar datos donde son débiles
Asistentes de voz y palabras de activación: datos diferentes, reglas similares
Cuándo (y cómo) utilizar datos estándar frente a datos personalizados
- Fuera de la plataforma:iniciar la cobertura en nuevos lugares y luego medir dónde aún hay confusión.
- Personalizado:captura el lenguaje de tu dominio (términos de política, nombres de productos) y la “voz de tu marca”.
- Mezclado:comience de manera amplia y luego agregue datos de alta precisión para las intenciones con mayor desviación o impacto en los ingresos.
Si necesita una forma rápida de empezar, Shaip ofrece recopilación de locuciones y conjuntos de datos de voz/chat listos para usar en muchos idiomas; consulte el estudio de caso sobre la implementación de un asistente multilingüe.
Lista de verificación de implementación
- Definir intenciones y entidades con ejemplos y negativas cases
- Autor variado, equilibrado Enunciados para cada intención (comience con algo pequeño y aumente semanalmente)
- Agregue validadores (idioma, galimatías, duplicados, expresiones regulares) antes del entrenamiento
- Configuración bucles de revisión del tráfico real; promover elementos ambiguos para la formación
- Seguimiento intención de salud y colisiones; solucionar con nuevas expresiones
- Reevaluar por canal/localidad para detectar la desviación de manera temprana
Cómo puede ayudar Shaip
- Recopilación y etiquetado de enunciados personalizados (chat + voz) con validadores para mantener la calidad alta.
- Conjuntos de datos listos para usar en más de 150 idiomas y variantes para un arranque rápido.
- Programas de revisión continua que convierten el tráfico en vivo en datos de entrenamiento de alta señal, de manera segura (controles PII).
Explore nuestro estudio de caso sobre la recopilación de expresiones multilingües.